

 DE
 EN




Zwei Shops, derselbe Abend, derselbe Fehler: Um 19:40 Uhr stirbt jeweils der Checkout. Der eine Betreiber bekommt um 19:44 Uhr eine Nachricht aufs Telefon — „Bestellrate 0 seit 4 Minuten, Kaufstrecke rot“ —, öffnet das Runbook und hat um 20:10 Uhr wieder einen funktionierenden Shop. Die andere Betreiberin erfährt es um 22:50 Uhr aus einer freundlichen Kundenmail: „Wollte bestellen, ging nicht, habe es woanders gekauft.“ Drei Stunden Unterschied — nicht im Ausfall, nur im Bemerken. Im Juni sind drei Stunden ärgerlich. Am letzten Novemberwochenende sind sie der Unterschied zwischen einer Anekdote und einem ruinierten Quartal.
Nach dem Beitrag zu den KI-Produkttexten kehrt die Serie heute zur Technik zurück — und schließt dort einen Bogen: Der Hosting-Beitrag hat geklärt, wie viel Ihr Shop tragen muss, der Lasttest, wo sein Limit wirklich liegt. Heute kommt das Nervensystem dazu: sehen, was passiert, die richtigen Menschen wecken und im Ernstfall nach Plan handeln statt nach Puls. Drei Themen, ein Beitrag — Monitoring, Alarmierung, Notfallplan — plus das Datum, an dem Ihr letzter regulärer Deploy dieses Jahres stattfindet.
Eine Abgrenzung vorweg: Welche fünf Zahlen Sie am Black Friday selbst live im Blick behalten, gehört in den Endspurt-Beitrag Ende November. Heute bauen wir das System, das diese Zahlen dann liefert — denn ein Monitoring, das erst in der Black Week eingerichtet wird, kennt den Normalzustand nicht und alarmiert entweder dauernd oder nie.
Warum der Kunde immer zuerst da ist
Dass Betriebsunterbrechungen kein Nischenproblem sind, zeigt jedes Jahr das Allianz Risk Barometer — in der aktuellen Ausgabe, befragt wurden über 3.300 Fachleute aus rund 100 Ländern, stehen sie hinter Cybervorfällen und KI-Risiken auf Platz drei der größten Geschäftsrisiken weltweit — zum ersten Mal überhaupt nicht unter den ersten beiden, und trotzdem seit Jahren ununterbrochen in der Spitzengruppe. Für einen Onlineshop im Dezember ist die Rangfolge ohnehin akademisch: Was immer die Ursache ist — Cyberangriff, Konfigurationsfehler, überlastete Datenbank —, beim Shop kommt es als dasselbe an: Es wird nicht gekauft.
Was so ein Stillstand kostet, müssen Sie nicht in fremden Studien suchen — die Zahl steht in Ihrem eigenen Backend: Umsatz einer starken Dezemberwoche geteilt durch ihre Stunden. Bei einem Shop mit 100.000 Euro Wochenumsatz im Peak sind das grob 600 Euro je Stunde im Schnitt — in den Abendstunden ein Mehrfaches davon. Drei unbemerkte Stunden am Peak-Abend sind damit ein vierstelliger Betrag, plus die Kundschaft, die nicht wiederkommt.
Und trotzdem ist die verbreitetste Monitoring-Strategie im Mittelstand die Kundin aus dem Eingangsbeispiel. Die zweitverbreitetste ist kaum besser: der Ping des Hosters. Der prüft, ob der Server antwortet — nicht, ob man kaufen kann. Eine Startseite, die brav ihren 200er-Status liefert, während die Kasse seit Stunden einen Fehler wirft, ist kein konstruiertes Beispiel, sondern der Normalfall des halb überwachten Shops: Das Zahlungsmodul hat sich verschluckt, ein Update hat ein JavaScript zerlegt, ein Zertifikat ist abgelaufen — der Server läuft, der Umsatz nicht.
Was ein Shop wirklich überwachen muss
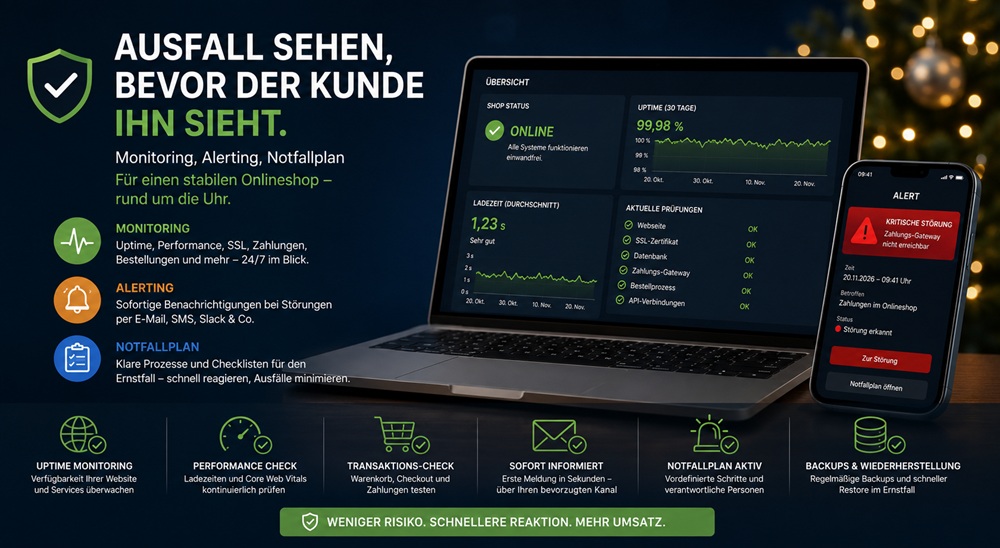
Ein belastbares Shop-Monitoring hat drei Ebenen, und die wichtigste ist die, die am seltensten eingerichtet wird.
Der Außenblick prüft im Minutentakt von außerhalb, was ein Kunde erlebt: Ist der Shop erreichbar, wie schnell antwortet er — und, entscheidend: funktioniert die Kaufstrecke? Ein synthetischer Durchlauf, der regelmäßig einen Artikel in den Warenkorb legt und bis zum letzten Schritt vor dem Kaufabschluss klickt, findet die kaputte Kasse, die der Ping nie sieht. Der Innenblick beobachtet die Technik dahinter: Auslastung von Prozessor, Speicher und Festplatte, die Fehlerrate in den PHP-Logs, Warteschlangen, und — gern vergessen — ob die geplanten Aufgaben laufen: Cronjobs, Feed-Exporte, der Bestandsabgleich aus dem ERP-Beitrag dieser Serie. Und die Geschäftsebene misst das, worum es eigentlich geht — und die trägt die ehrlichste Kennzahl des ganzen Systems:
Die Bestellrate gegen ihre eigene Baseline. Bestellungen je Viertelstunde, verglichen mit dem üblichen Wert für diesen Wochentag und diese Uhrzeit. Diese eine Zahl fängt alles, was jede andere Prüfung übersieht: das still gestorbene Zahlungsmodul, den JavaScript-Fehler, der nur im Checkout zündet, die Aktion, deren Gutscheincode nicht funktioniert. Der Shop kann technisch grün sein und wirtschaftlich tot — die Bestellrate sieht es. Ihr einziger Preis ist Vorlauf: Sie braucht eine eingeschwungene Baseline, und genau deshalb wird sie jetzt eingerichtet, Anfang November, nicht am 25. Und ihr Fundament sind Protokolle, die den Namen verdienen: Der IT-Grundschutz des BSI verlangt im Baustein Protokollierung nicht nur, dass relevante Ereignisse überhaupt protokolliert werden — er empfiehlt eine zentrale Sammelstelle, die auch „allgemeine Betriebsereignisse, die auf einen Fehler hindeuten“ erfasst, und besteht auf synchronen Systemuhren. Letzteres klingt pedantisch, bis man um 20 Uhr abends Webserver-, Datenbank- und Zahlungslogs nebeneinanderlegt und drei verschiedene Uhrzeiten für denselben Fehler liest.
Alarmieren heißt: der richtige Mensch, geweckt, mit Kontext
Ein Monitoring ohne Alarmierung ist ein Tagebuch. Damit aus Messwerten Reaktionen werden, braucht es drei Entscheidungen, die der BSI-Grundschutz im Baustein Detektion auf den Punkt bringt: Melde- und Alarmierungswege müssen festgelegt und dokumentiert sein, es muss bestimmt sein, welche Stellen wann zu informieren sind — und die Wege sollen regelmäßig erprobt werden. Übersetzt in den Shop-Alltag:
Schwellen mit Augenmaß. Nicht jeder Ausschlag ist ein Alarm — wer bei jeder langsamen Antwort klingelt, erzieht sein Team binnen einer Woche zum Wegwischen, und der eine echte Alarm ertrinkt in dreißig falschen. Bewährt: Erreichbarkeit und Kaufstrecke alarmieren nach zwei aufeinanderfolgenden Fehlversuchen, die Bestellrate bei deutlichem Einbruch gegen die Baseline über zwei Intervalle. Eine Eskalationskette mit Namen. Erster Kanal die Team-Nachricht, nach zehn Minuten ohne Reaktion der Anruf, dazu eine benannte Vertretung — der Dezember kennt Urlaub und Krankheit. Im vierten Quartal gibt es dabei bewusst keine „stillen Stunden“ für die harten Alarme: Ein toter Checkout um 23 Uhr am 27. November darf wecken. Und Kontext im Alarm selbst. „Shop down“ ist keine Nachricht, sondern ein Rätsel. „Kaufstrecke Schritt 3 (Zahlung) fehlgeschlagen seit 19:41, Fehlerrate PHP 8×normal, Runbook: Kasse“ ist eine — sie spart die Viertelstunde Diagnose, die um diese Uhrzeit am teuersten ist. Und wie der BSI sagt: erproben. Ein Testalarm pro Monat, im November einer pro Woche — wer den Ernstfall nie geprobt hat, probt ihn im Ernstfall.
Ein Alarmweg wird dabei regelmäßig vergessen: der ins eigene Marketing. Wenn der Checkout steht, laufen Anzeigen, Preisvergleichs-Einträge und die Mailstrecke aus dem Kampagnen-Beitrag ungerührt weiter — bezahlter Traffic auf einen Shop, der nicht verkaufen kann, ist doppelter Verlust. Zur Eskalationskette gehört deshalb der Punkt: Ab welcher Ausfalldauer werden Kampagnen pausiert, und wer darf das? Bei einem Fünf-Minuten-Schluckauf niemand; ab einer halben Stunde die benannte Person mit Zugriff auf die Werbekonten. Auch das ist eine Zeile im Runbook — und im Dezember bares Geld.
Das Runbook: erste Hilfe ohne Nachdenken
Der Notfallplan eines Shops muss kein Ordner sein. Fünf Seiten reichen — eine je Szenario: Shop nicht erreichbar, Kasse defekt, eine Zahlart gestört, Shop extrem langsam, Verdacht auf Angriff. Jede Seite hat dieselbe Struktur: Woran erkenne ich es (Symptom und Alarmtext), was prüfe ich zuerst (drei Checks in fester Reihenfolge), was ist die Sofortmaßnahme (und was ausdrücklich nicht — der panische Deploy um 21 Uhr steht auf jeder Seite unter „nicht“), wer entscheidet über weitere Schritte, und wie kommunizieren wir: der vorbereitete Hinweisbanner im Shop, der vorformulierte Social-Post, ab welcher Dauer die Info an Stammkunden. Dazu gehört die Zugangsliste, ohne die jedes Runbook Dekoration ist: Hoster-Notfallnummer und Kundennummer, Admin-Zugänge samt der Frage, wer die Zwei-Faktor-Codes empfängt, die Rufnummern von Agentur und Zahlungsdienstleister — auf Papier oder in einem Speicher, der auch dann erreichbar ist, wenn der Shop es nicht ist.
Zwei Sorgen lassen sich dabei nehmen. Die erste: „Ein Ausfall ruiniert unser Google-Ranking.“ Kurzfristig nein — Googles Dokumentation zu Serverfehlern ist eindeutig: 5xx-Fehler sorgen zunächst dafür, dass die Crawler das Crawling vorübergehend verlangsamen; erst URLs, die dauerhaft Serverfehler liefern, werden aus dem Index entfernt, und nach der Rückkehr zu normalen Antworten steigt die Crawling-Frequenz wieder. Ein Abend Ausfall ist ein Umsatzproblem, kein Rankingproblem — also gehört die Energie in die Wiederherstellung, nicht in SEO-Panik. Die zweite Sorge: „Wir machen den Fehler schlimmer.“ Genau dafür gibt es die Sofortmaßnahmen-Spalte und ihre Grenze: Was das Runbook nicht vorsieht, entscheidet der benannte Verantwortliche — nicht der Adrenalinspiegel.
Und zum Runbook gehört eine letzte Seite, die erst nach dem Vorfall ausgefüllt wird: die Nachbereitung. Drei Fragen, eine Viertelstunde, am nächsten Werktag: Wie haben wir es bemerkt — und hätte es schneller gehen können? Was war die Ursache, nicht das Symptom? Und welcher eine Eintrag im Monitoring, im Runbook oder in der Zugangsliste hätte den Abend leichter gemacht? Wer das nach jedem Vorfall diszipliniert beantwortet, hat nach einer Saison ein Notfallsystem, das aus echten Fällen gelernt hat — und nicht aus Vermutungen vom Oktober.
Code-Freeze: der letzte Deploy hat ein Datum
Die stille Wahrheit hinter vielen Dezember-Ausfällen: Sie wurden im Dezember deployt. Deshalb bekommt der letzte reguläre Deploy des Jahres ein Datum, und das liegt in der Woche bis Freitag, den 13. November — danach ist Code-Freeze bis nach dem Jahreswechsel. Der Freeze ist kein Denkverbot, sondern eine Sortierung: Eingefroren sind Code, Templates, Plugins, Schnittstellen und alles, was eine Regressionsprüfung bräuchte. Weiter laufen Inhalte, Preise, Kampagnenwerte, Puffer und Schwellen — genau die Justierungen, die die Beiträge zu Kampagne und Streichpreisen in den November gelegt haben. Für den echten Notfall gibt es die Ausnahme mit Prozess statt Bauchgefühl: Ein Hotfix braucht vier Augen, einen getesteten Rollback-Weg und einen Eintrag ins Ausfallprotokoll — sonst wird aus einem kleinen Fehler um 18 Uhr ein großer um 19 Uhr. Und das Staging bleibt offen: Was dem Team im Dezember einfällt, wird dort gesammelt und im Januar gebaut.
Was Sie diese Woche tun — und was bis zum 13. November steht
Diese Woche: Außenblick einrichten — Erreichbarkeit plus Kaufstrecken-Durchlauf im Minutentakt — und den Bestellraten-Alarm aufsetzen, damit er bis zur Black Week drei Wochen Baseline gesammelt hat. Dazu die Zugangsliste schreiben; sie kostet eine Stunde und ist im Ernstfall die wertvollste Seite des Runbooks.
Bis zum 13. November: die fünf Runbook-Seiten schreiben und mit allen Beteiligten durchsprechen, die Eskalationskette mit Namen und Vertretung festlegen, einen Testalarm auslösen — und eine halbe Stunde Ernstfall proben: Jemand schaltet im Staging die Kasse ab, das Team arbeitet das Runbook durch, danach wird das Runbook korrigiert, nicht das Team. In derselben Woche läuft der letzte reguläre Deploy. Ab dann: beobachten, justieren, nichts mehr bauen. Die fünf Zahlen für den Tag selbst übernimmt der Endspurt-Beitrag Ende November. Wenn Sie Monitoring, Alarmierung und Runbook nicht allein aufsetzen wollen — das ist der Kern unserer laufenden Shop-Wartung und -Betreuung, und der November ist der letzte gute Monat dafür.
Häufige Fragen zu Shop-Monitoring und Notfallplan
Welche Werte sollte ein Onlineshop überwachen?
Drei Ebenen: von außen die Erreichbarkeit und ein synthetischer Kaufstrecken-Durchlauf bis zum letzten Schritt vor dem Kaufabschluss, von innen die Serverwerte, die Fehlerrate in den Logs und die geplanten Aufgaben wie Cronjobs und Feed-Exporte — und auf der Geschäftsebene die Bestellrate je Viertelstunde gegen ihre übliche Baseline. Die dritte Ebene ist die wichtigste und seltenste: Sie bemerkt auch Fehler, bei denen technisch alles grün aussieht, etwa ein still gestörtes Zahlungsmodul.
Reicht das Monitoring meines Hosters nicht aus?
Nein. Der Hoster prüft, ob der Server antwortet — nicht, ob man kaufen kann. Eine Startseite kann fehlerfrei ausliefern, während die Kasse seit Stunden einen Fehler wirft: abgelaufenes Zertifikat, gestörtes Zahlungsmodul, ein JavaScript-Fehler aus dem letzten Update. Das sieht nur ein Check, der die Kaufstrecke tatsächlich durchklickt, plus eine Bestellrate mit Baseline. Das Hoster-Monitoring bleibt sinnvoll — als unterste der drei Ebenen, nicht als einzige.
Was ist die wichtigste Kennzahl für das Shop-Monitoring?
Die Bestellrate gegen ihre eigene Baseline: Bestellungen je Viertelstunde im Vergleich zum üblichen Wert für diesen Wochentag und diese Uhrzeit. Sie ist die einzige Kennzahl, die jeden umsatzrelevanten Fehler fängt, auch die unsichtbaren — kaputter Gutscheincode, gestörte Zahlart, Checkout-Fehler nur auf Mobilgeräten. Ihr Preis ist Vorlauf: Sie braucht zwei bis drei Wochen eingeschwungene Vergleichswerte und gehört deshalb Anfang November eingerichtet, nicht in der Black Week.
Wie schreibe ich einen Notfallplan für meinen Shop?
Als Runbook mit fünf Seiten, eine je Szenario: Shop nicht erreichbar, Kasse defekt, Zahlart gestört, Shop extrem langsam, Verdacht auf Angriff. Jede Seite beantwortet in fester Struktur: Woran erkenne ich es, was prüfe ich zuerst, was ist die Sofortmaßnahme und was ausdrücklich nicht, wer entscheidet, wie kommunizieren wir nach außen. Dazu gehört eine Zugangsliste mit Hoster-Notfallnummer, Admin-Zugängen und Dienstleister-Kontakten, gespeichert an einem Ort, der auch bei Shop-Ausfall erreichbar ist — und eine halbe Stunde Übung vor der Saison.
Schadet ein Ausfall meinen Google-Rankings?
Ein kurzer Ausfall nicht. Nach Googles Dokumentation verlangsamen Serverfehler zunächst nur vorübergehend das Crawling; erst URLs, die dauerhaft Serverfehler zurückgeben, werden aus dem Index entfernt, und nach der Rückkehr normaler Antworten steigt die Crawling-Frequenz wieder an. Ein Abend Stillstand ist also ein Umsatz- und Vertrauensproblem, kein Rankingproblem. Die Energie im Ernstfall gehört deshalb in die Wiederherstellung und die Kundenkommunikation — nicht in hektische SEO-Maßnahmen.
Wann sollte der Code-Freeze vor dem Weihnachtsgeschäft beginnen?
Der letzte reguläre Deploy gehört in die Woche bis Mitte November — in diesem Jahr bis Freitag, den 13. November —, danach gilt der Freeze bis nach dem Jahreswechsel. Eingefroren sind Code, Templates, Plugins und Schnittstellen; weiter laufen Inhalte, Preise, Kampagnen- und Pufferwerte. Für Notfälle gibt es den Hotfix-Prozess mit vier Augen, getestetem Rollback und Protokolleintrag. Neue Ideen sammelt das Staging — gebaut wird im Januar, wenn Fehler wieder billig sind.
Fazit: Ausfälle passieren — Überraschungen sind optional

Gegen den Ausfall selbst gibt es keine Garantie, gegen das dreistündige Nichtbemerken schon. Die Zutaten sind unspektakulär: ein Außenblick, der kauft statt pingt, eine Bestellrate mit Baseline, Alarme mit Namen, Wegen und Kontext, fünf Runbook-Seiten mit Zugangsliste — und ein Kalender, der den letzten Deploy auf den 13. November legt. Nichts davon braucht Enterprise-Werkzeuge; alles davon braucht die zwei ruhigen Wochen, die jetzt noch da sind.
Wenn Sie aus diesem Beitrag eine Sache mitnehmen: Richten Sie diese Woche den Bestellraten-Alarm ein. Er ist in einem Nachmittag gebaut, und er ist der eine Wächter, der alles bemerkt — auch die Fehler, an die heute noch niemand denkt.
Wie haben Sie Ihren letzten Ausfall bemerkt?
Die ehrliche Frage zuerst: Kam die Nachricht von Ihrem Monitoring — oder von einem Kunden? Und wie lange lag der Fehler da schon zurück? Genau diese Zahl entscheidet darüber, ob sich Ihr aktuelles Setup Monitoring nennen darf.
Und an die, die schon mit Bestellraten-Alarm fahren: Welchen Fehler hat er gefangen, den kein technischer Check gesehen hat? Diese Geschichten sind die beste Werbung für die unscheinbarste Kennzahl des Shops — erzählen Sie mir Ihre.
Wenn Sie Ihr Monitoring vor der Saison von uns aufsetzen lassen möchten, erreichen Sie uns über die Kontaktseite.
Dieser Beitrag ist Teil unserer Q4-Serie. Jeden Dienstag erscheint hier ein neuer Beitrag zur Vorbereitung auf die Hochsaison. Nächste Woche: Trust-Signale — was Erstkäufer im Dezember wirklich überzeugt.
 {% endif %}
{% if title and title != "" %}
{{ title }}
{% endif %}
{% if excerpt and excerpt != "" %}